
记得几个词
搜索标题、网址和文件夹中的词语,也支持中文子串。
“sqlite 向量索引”
不必先整理好每个文件夹。先试试关键词;配置向量模型后,也可以用自己的话描述内容。保存时间和关联页面帮助你继续缩小范围。
搜索标题、网址和文件夹中的词语,也支持中文子串。
“sqlite 向量索引”
配置向量模型后,用内容描述寻找相关页面。结果取决于已索引内容和所用模型。
“让应用在断网时也能搜索”
按保存日期筛选,再查看同一浏览批次里的其他书签。
“上个月收藏的数据库文章”
检索能力和限制都有记录。阅读评测方法与结果。
在 Python 3.10+ 环境中安装,导入书签,然后打开应用。完整教程会带你选择模型、建立索引,并区分本机使用与服务器访问。
python -m pip install facetmark
facetmark import
facetmark index --no-fetch
facetmark serve
只想先体验?运行 facetmark demo。它使用离线生成的示例书签,不需要 API Key。
--no-fetch 跳过网页下载;已有的正文仍可使用。facetmark index。facetmark demo 的真实输出,它会离线造一个 60 页的合成书签库。provider 是 mock,所以这是一次管路体检,不是质量度量 —— mock 是把文本哈希成向量的。分数列看上去没排序,是因为名次来自重排阶段,而分数是融合分,重排故意不去覆盖它。内容向量、生成的提问、关键词和子串,是不同的检索信号。有向量模型时,默认使用内容向量、图谱扩展和时间衰减;其他组合可在搜索选项中比较。没有模型时,仍可使用词面搜索。
| 面 | 索引的是什么 | 回答什么样的问题 | 默认 |
|---|---|---|---|
| 词面 两个 FTS5 索引 | 标题、URL、正文的字符三元组和词段。 | 精确字符串、ID、代码、报错信息,以及没有空格可分的中文。 | 关 融合时输了 5.4pp |
| 内容面 稠密向量 | 页面正文抽取后的嵌入,不是标题的。 | 换说法。词忘了、意思还在的那种。 | 开 W1 赢家,0.643 |
| 意图面 生成的查询 | 模型为这个页面写的候选问法,再用「能不能把这页捞回来」过滤一遍。 | 你以后会怎么开口找它。 | 关 只有 38% 的意图站得住 |
| 上下文面 会话与图 | 保存会话聚类、域名结构,以及全库的链接图。 | 「我存那个的时候还顺手存了哪些?」 | 图扩展开 情景门关 +2.09pp / −18.83pp |
这四个结论每一个都对应实测页上一份协议、一套查询集和一个置信区间。
有颜色的阶段是出厂默认真的会跑的。灰色的是写了、测了、然后关掉的。每一个索引阶段都是幂等的并且带指纹,所以 facetmark index 只会重做输入变了的那部分。
四路并行默认只开一路
从融合这一步分出去
默认真正走的路径写好了、接好了,默认关着
bookmark → fetch → content → enrich(摘要、主题、实体、要点)→ embed → intents → 过滤 → sessions → edges。
富化按正文哈希计算;嵌入按重建后的嵌入文本计算 —— 所以一个和自己文本对不上的向量会被发现,而不是被相信。--force 两个都不看。
从融合结果往外走一跳,作为单独一组返回,不混进排名里。实测 +2.09pp,10 胜 0 负,9 ms。
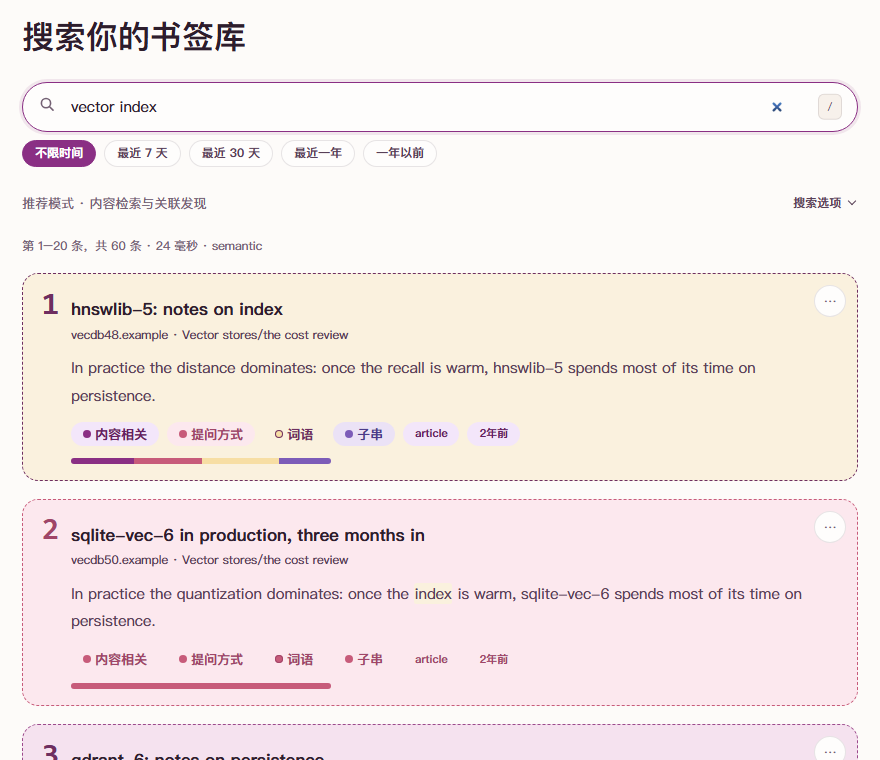
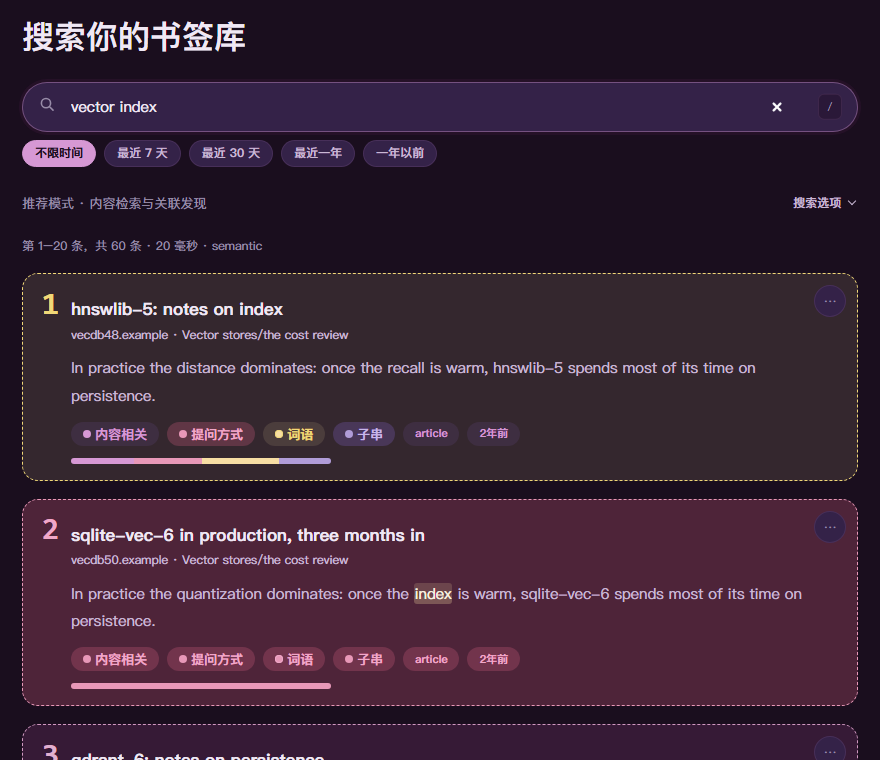
搜索结果可以展开查看摘要与来源;综述把相关资料整理成带引用的回答;书签库展示正文和索引的覆盖情况。桌面与手机使用同一套界面。
domain:github.com、tag:work、added:<7d、-pinterest、sort:date——都在同一个输入框里,字段名和你库里真实存在的值都会补全。只有过滤器的查询是一次浏览:完全不调用模型。
令牌来自一条只在调用方和请求里写的地址两者都是回环地址时才回答的路由,所以在你自己机器上没有什么要复制的。换个地方,页面会让你粘贴一次。
空的书签库会把导入命令打出来。有书签但没有向量,就打 facetmark index。搜不到东西而抓取队列还排着,它会直接告诉你,而不是甩给你一个空列表让你猜。
顶栏一个开关,下次来还记得。浅色、深色,或者跟随系统。/ 聚焦搜索框,上下键走结果,Esc 清空。
Manifest V3。主机权限只有 http://127.0.0.1:8787/* 和 http://localhost:8787/*。它只访问你自己的机器,用一个配对令牌握手,并且从不写你浏览器的书签库。
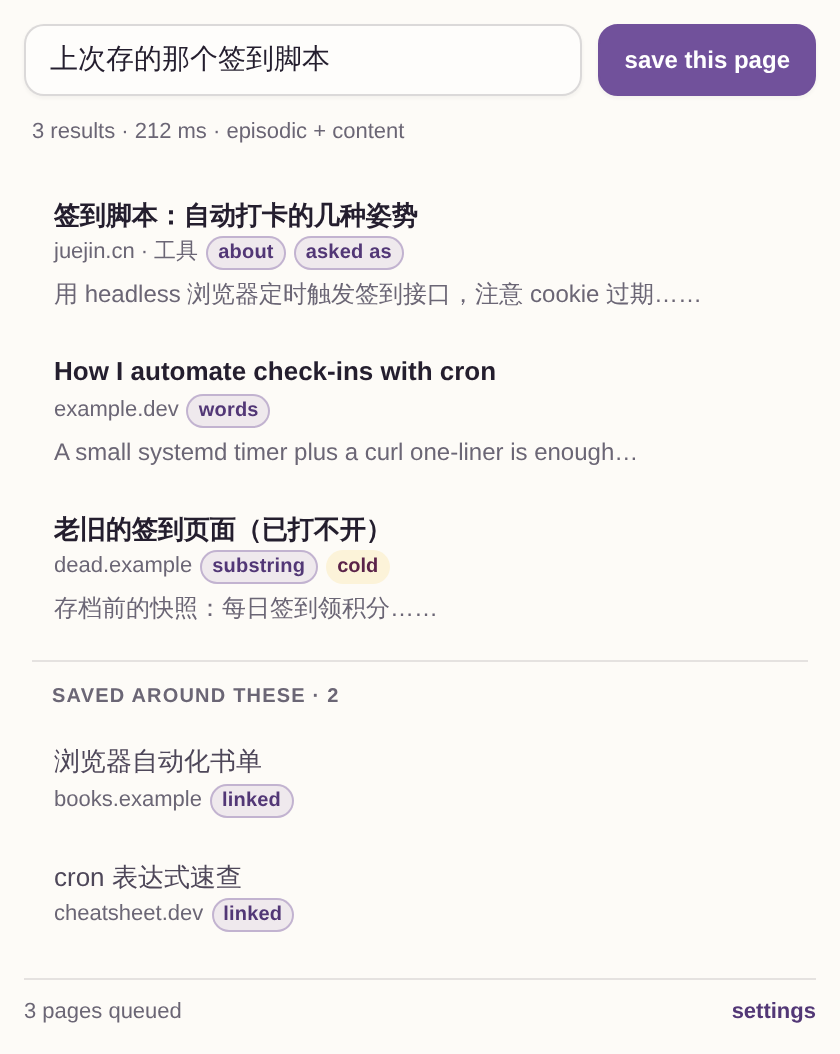
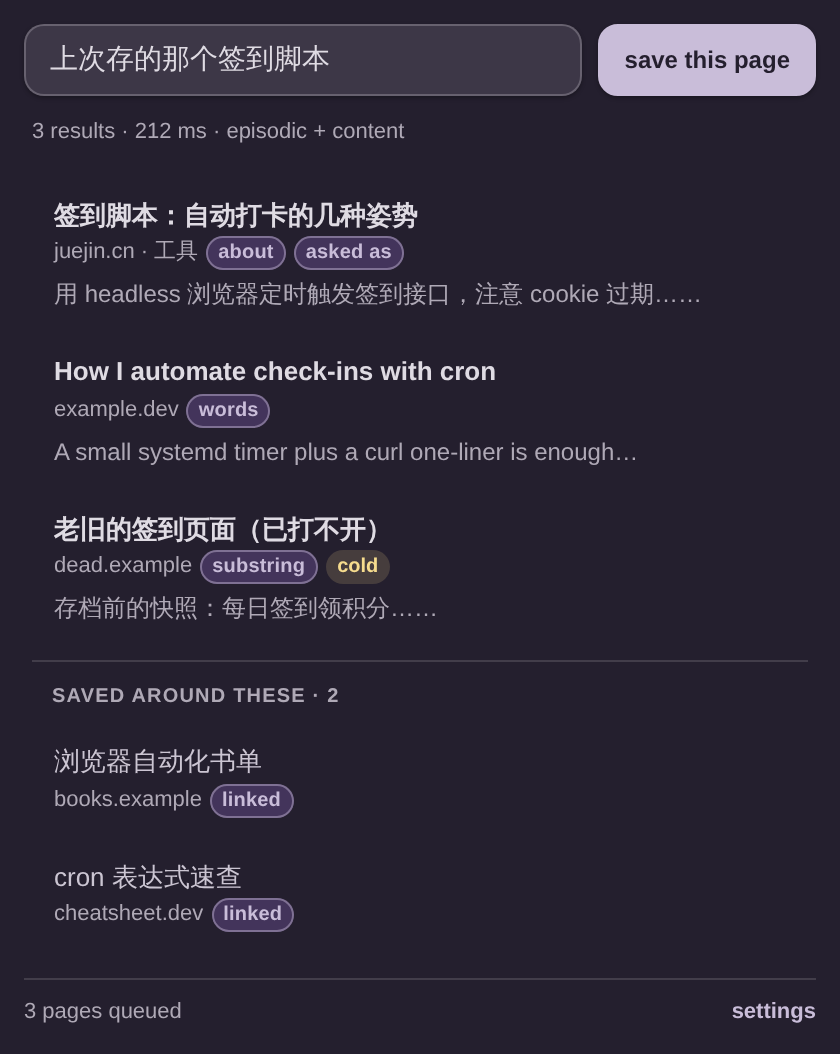
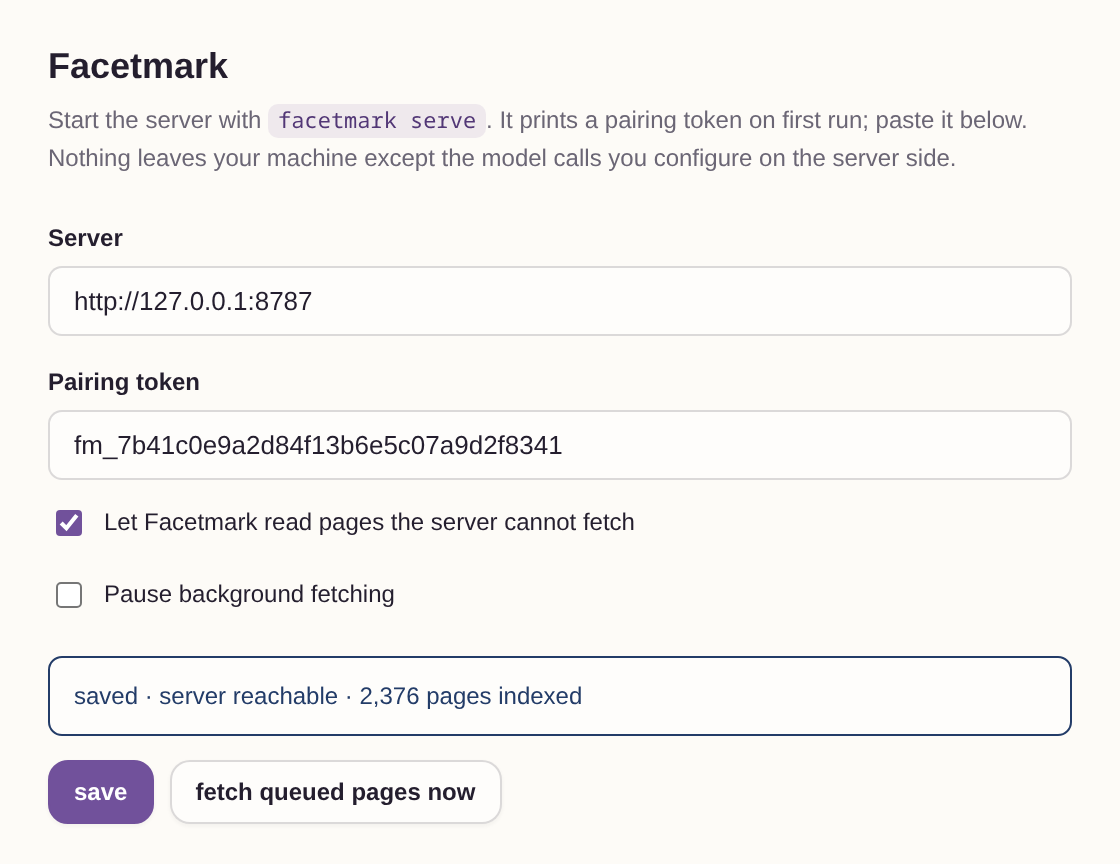
facetmark health。这些是用 mock 数据渲染的界面预览,不是真实库的截图 —— 真的截一张,等于把某个人的浏览历史贴到公开网页上。
这个项目有意思的部分不是那些成功的功能,而是那些写完了、预注册了、测完了、然后被关掉的 —— 包括一个已经发出去的。
三条标准在跑之前就写好了。三条全没达到。融合付出了 5.4 个百分点的 Recall@5,并且把查询变慢了 3.5 倍 —— p50 从 148 ms 到 526 ms。四面融合的默认当天就撤了。
那一轮里活下来两个,现在都在跑:图扩展作为单独一组返回(+2.09pp,10 胜 0 负,p=0.0019),以及重排对 Recall@1 的提升(+4.80pp,CI95 [+1.46, +8.35])。
然后是情景门。它在自己的 holdout 上赢了(+3.09pp,19 胜 0 负,p=3.8e−6)并且发了出去。之后另建的 361 条探针集问了另一个问题 —— 它在不该触发的查询上触发了会怎样?答案是 −18.83pp,3 胜 71 负。默认回滚了。
facetmark serve 会在 /app 上开一个搜索页。搜索加书签库概览,中英文、深浅色都能切。这是唯一一个除了 facetmark 本身什么都不用装的入口。
21 条命令。search 有 --explain 可以打印命中的是哪个面,--config 可以按名字跑任何一个消融档。
facetmark serve 监听 127.0.0.1:8787。29 条路由,其中四条公开 —— 根路径、健康检查,以及本地页面加载自己需要的那两条;凡是碰到书签库的都要配对令牌。
facetmark mcp 在 stdio 上说 MCP。9 个工具、3 个资源,Claude Desktop 可以直接搜你的库、读一次保存会话。
MV3。地址栏关键字 fm、Ctrl+Shift+K、一键保存并进本地索引队列。
一个搜索提供者插件,把 facetmark 接到 karakeep 自己的搜索框后面。协议格式由一个回放测试钉死。
书签库保存在运行服务的机器上。网页抓取会访问收藏的网站;使用在线模型时,相关文本与查询会发送到你配置的服务商。服务器部署时,导入文件会传到该服务器。
本地向量模型可在模型文件下载后本机计算。是否调用在线对话模型取决于你的配置;facetmark 不提供托管账户或集中存储服务。
不会。导入是单向只读。导入器打开浏览器配置里的 Bookmarks 文件或者你导出的 HTML,读完就关。代码里没有任何一处往浏览器配置里写东西。
facetmark 这边也不删。衰减层只会把陈旧页面往后排,从来不删行。
能,会差,而且它会告诉你差在哪。不接模型,你保留两个词面、整套保存会话和域名图。你失去内容面 —— 就是测得最好的那个 —— 和意图面。
折中方案:只跑一个本地嵌入模型支撑内容面,不接 chat 模型。你失去摘要和生成意图,保住换说法搜索。
费用取决于页面数量、文本长度、所选模型和服务商定价。先用少量书签验证连接和结果,再处理完整书签库。
抓取速度还受网站响应、访问限制和按域名限速影响。后续运行会复用未变化的阶段;缺少正文和已生成向量是两种不同的状态。
因为四面融合在 479 条真实查询上被测了,结果比单独用内容面低 5.4 个百分点的 Recall@5,延迟还高 3.5 倍。
机制也写下来了:平权重的 RRF 下,两个弱面碰巧的一致(0.0279)能投赢一个强面的确定(0.0164)。四个面都还在,都还有测试。--config C 一下就全打开了,你可以自己看。
适合想自己管理书签数据、按内容找回旧资料,并愿意配置本机或服务器环境的人。它也提供 CLI、HTTP API 和 MCP,方便接入已有工具。
检索效果有明确边界:目前公开评测的查询由项目作者编写。请结合自己的书签验证,不把单一数据集的数字当作保证。
导入从不写回。你的文件夹树还是你的。
冷层只降权。它不删行,而且 facetmark health 会告诉你它认为哪些死了、为什么。
一个 SQLite 文件,任何 SQLite 工具都能打开。就算你不用 facetmark 了,数据也还读得出来。
遵守 robots.txt,单域名并发封顶 2,同一主机两次请求之间有最小间隔,UA 里写清楚自己是谁。
没有一套提前冻结的查询集,就不改默认值。